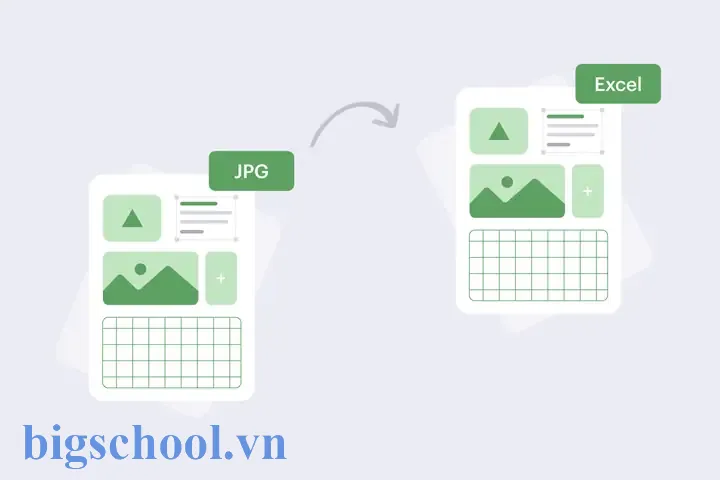
Trong thời đại số hoá, việc xử lý dữ liệu nhanh chóng và chính xác đã trở thành yêu cầu thiết yếu đối với cá nhân và doanh nghiệp. Một trong những nhu cầu phổ biến nhưng không kém phần khó khăn là chuyển đổi dữ liệu từ hình ảnh (picture) sang bảng tính Excel. Dù là các bảng thống kê được chụp từ báo cáo, hoá đơn, phiếu xuất nhập kho, hay các biểu đồ, đồ thị trong tài liệu scan, việc trích xuất thông tin một cách tự động sẽ tiết kiệm thời gian, giảm thiểu sai sót và tăng năng suất làm việc. Bài viết dưới đây sẽ cung cấp cho bạn một hướng dẫn chi tiết, từ những khái niệm cơ bản, quy trình thực hiện, các công cụ hỗ trợ miễn phí và trả phí, cho tới những lưu ý quan trọng khi làm việc với dữ liệu được chuyển đổi.
Có thể bạn quan tâm: Convert Excel To Exe Software: Giải Pháp Đột Phá Đưa Dữ Liệu Thành Ứng Dụng Độc Lập
1. Tại sao cần chuyển đổi ảnh sang Excel?
1.1. Tiết kiệm thời gian
- Nhập liệu thủ công: Khi nhận được một bảng dữ liệu dưới dạng ảnh, nhiều người vẫn lựa chọn nhập tay từng ô. Với một bảng 100 dòng, 10 cột, thời gian có thể lên tới vài giờ.
- Tự động hoá: Công cụ OCR (Optical Character Recognition) cho phép nhận dạng ký tự và số trong ảnh, tự động tạo bảng Excel chỉ trong vài giây.
1.2. Đảm bảo độ chính xác
- Nhân lực luôn có khả năng mắc lỗi khi gõ số, đặc biệt là các giá trị dài, dấu thập phân, hoặc ký tự đặc biệt.
- Các phần mềm OCR hiện đại có độ chính xác lên tới 98‑99% (tùy vào chất lượng ảnh), giảm thiểu sai sót đáng kể.
1.3. Dễ dàng phân tích và xử lý dữ liệu
- Khi dữ liệu đã ở dạng Excel, bạn có thể sử dụng công cụ PivotTable, biểu đồ, hàm tính toán để phân tích nhanh chóng.
- Dữ liệu có thể đồng bộ với các hệ thống ERP, CRM, hoặc phần mềm kế toán.
1.4. Hỗ trợ công việc từ xa và số hoá tài liệu
- Trong môi trường làm việc từ xa, việc nhận và chia sẻ tài liệu dưới dạng ảnh là phổ biến. Chuyển đổi sang Excel giúp các thành viên trong nhóm cùng làm việc trên một file chung, không cần phải nhập lại.
Có thể bạn quan tâm: Content Marketing Plan Template Excel: Hướng Dẫn Chi Tiết Từ A → Z Để Tối Ưu Hoá Chiến Lược Nội Dung
2. Các khái niệm cơ bản liên quan đến OCR và chuyển đổi
| Thuật ngữ | Giải thích |
|---|---|
| OCR (Optical Character Recognition) | Công nghệ nhận dạng ký tự quang học, chuyển đổi hình ảnh chứa văn bản thành dữ liệu có thể chỉnh sửa. |
| Layout Detection | Phân tích cấu trúc bố cục của ảnh (bảng, cột, hàng) để tạo ra bảng dữ liệu đúng định dạng. |
| Pre‑processing | Các bước xử lý ảnh trước khi OCR (làm sạch nền, tăng độ tương phản, xoay ảnh) để cải thiện độ chính xác. |
| Post‑processing | Kiểm tra, chỉnh sửa dữ liệu sau OCR (sửa lỗi chính tả, định dạng số, chuẩn hoá ngày tháng). |
| API OCR | Giao diện lập trình ứng dụng cho phép tích hợp OCR vào phần mềm, website hoặc workflow tự động. |
Có thể bạn quan tâm: Mẫu Lịch Trình Dự Án Xây Dựng Excel: Hướng Dẫn Chi Tiết Từ A Đến Z
3. Quy trình chuyển đổi ảnh sang Excel chuẩn
Bước 1: Chuẩn bị ảnh gốc
- Chất lượng ảnh: Độ phân giải tối thiểu 300 DPI, ảnh rõ nét, không mờ. Đối với ảnh chụp bằng điện thoại, hãy bật chế độ tài liệu (document mode) để tự động tối ưu.
- Định dạng ảnh: PNG, JPEG, TIFF đều được hỗ trợ. Đối với ảnh đa trang, sử dụng PDF hoặc TIFF multi‑page.
- Loại bỏ nhiễu: Nếu ảnh có nền màu, vệt, hoặc các dấu vân tay, hãy dùng phần mềm chỉnh sửa (Photoshop, GIMP) hoặc công cụ trực tuyến để làm sạch.
Bước 2: Tiền xử lý (Pre‑processing)
- Cân bằng độ sáng/độ tương phản: Tăng độ tương phản giúp ký tự nổi bật hơn.
- Chuyển sang ảnh đen‑trắng (binary): Giảm độ phức tạp cho OCR.
- Xoay ảnh: Đảm bảo văn bản nằm ngang (0° hoặc 180°). Nhiều công cụ tự động phát hiện góc nghiêng.
- Cắt (crop): Loại bỏ viền, tiêu đề không liên quan.
Bước 3: Chọn công cụ OCR phù hợp
- Miễn phí: Google Drive OCR, Microsoft OneNote, OnlineOCR, i2OCR, Tabula (cho PDF bảng).
- Trả phí / Doanh nghiệp: Adobe Acrobat Pro DC, ABBYY FineReader, Tesseract (mã nguồn mở, cần lập trình), Amazon Textract, Google Cloud Vision API, Microsoft Azure Computer Vision.
Bước 4: Thực hiện OCR và xuất dữ liệu
- Upload ảnh lên công cụ.
- Chọn ngôn ngữ (Tiếng Việt, tiếng Anh, v.v.) để tăng độ chính xác.
- Chọn định dạng xuất: CSV, XLSX, hoặc Google Sheets.
- Chạy OCR và chờ kết quả.
Bước 5: Kiểm tra và chỉnh sửa (Post‑processing)
- Kiểm tra lỗi nhận dạng: Số 0 và O, 1 và I, dấu thập phân vs dấu phẩy.
- Định dạng cột: Thiết lập kiểu dữ liệu (Number, Date, Text) trong Excel.
- Xóa dòng trống, hợp nhất các ô bị tách sai.
- Sắp xếp lại tiêu đề nếu OCR không nhận đúng.
Bước 6: Lưu và chia sẻ
- Lưu dưới định dạng .xlsx để bảo toàn công thức, định dạng.
- Nếu cần chia sẻ nhanh, xuất ra CSV hoặc Google Sheet.
4. Đánh giá các công cụ OCR phổ biến
4.1. Google Drive OCR (Miễn phí)
Ưu điểm
– Tích hợp sẵn trong Google Drive, không cần cài đặt.
– Hỗ trợ nhiều ngôn ngữ, bao gồm tiếng Việt.
– Xuất ra Google Sheet nhanh chóng, đồng bộ trên đám mây.
Nhược điểm
– Không hỗ trợ tùy chỉnh layout phức tạp (bảng có tiêu đề lồng nhau, cell merge).
– Độ chính xác phụ thuộc vào chất lượng ảnh; không có tính năng tiền xử lý mạnh.
Cách dùng nhanh
1. Đăng nhập Google Drive → Upload file → Click chuột phải → “Open with” → “Google Docs”.
2. Tài liệu mở ra, nội dung OCR sẽ hiển thị dưới dạng văn bản. Chọn “File” → “Download” → “Microsoft Excel (.xlsx)”.
4.2. Microsoft OneNote (Miễn phí – có trong Office)
Ưu điểm
– Tích hợp OCR tự động khi dán ảnh vào note.
– Dễ dàng sao chép bảng đã nhận dạng vào Excel.
– Hỗ trợ tiếng Việt tốt.
Nhược điểm
– Không xuất trực tiếp ra file Excel, cần sao chép thủ công.
– Giao diện không thân thiện với người dùng muốn batch xử lý nhiều ảnh.
4.3. ABBYY FineReader (Trả phí)
Ưu điểm
– Độ chính xác cao (≥ 99% trên tài liệu sạch).
– Hỗ trợ layout detection mạnh, nhận dạng bảng đa cấp, merge cells.
– Cho phép chỉnh sửa trực tiếp trong giao diện, xuất ra Excel, CSV, PDF.
Nhược điểm
– Giá thành cao (gói Standard ~ $199, Corporate ~ $399).
– Yêu cầu PC chạy Windows hoặc macOS.
4.4. Adobe Acrobat Pro DC (Trả phí)
Có thể bạn quan tâm: Chuyển Từ File Ảnh Sang Excel: Hướng Dẫn Chi Tiết, Công Cụ Hiệu Quả Và Mẹo Tối Ưu
Ưu điểm
– Xử lý PDF đa trang tốt, chuyển đổi bảng PDF sang Excel mượt mà.
– Tích hợp công cụ Enhance Scan để tiền xử lý tự động.
Nhược điểm
– Chi phí thuê bao hàng tháng (~ $14.99), không chuyên cho OCR tiếng Việt (đôi khi cần cài đặt language pack).
4.5. Tesseract OCR (Mã nguồn mở)
Ưu điểm
– Hoàn toàn miễn phí, có thể tích hợp vào pipeline tự động (Python, Java, C#).
– Hỗ trợ đa ngôn ngữ, có mô hình tiếng Việt.
Nhược điểm
– Giao diện dòng lệnh, yêu cầu kiến thức lập trình.
– Không có tính năng layout detection mặc định; cần kết hợp với Tabula hoặc Camelot để trích xuất bảng từ PDF.
4.6. Các dịch vụ Cloud (Google Cloud Vision, Amazon Textract, Azure Computer Vision)
Ưu điểm
– API mạnh mẽ, khả năng xử lý hàng nghìn ảnh mỗi ngày.
– Hỗ trợ structured data extraction: nhận dạng các cột, hàng, thậm chí các biểu mẫu (form).
– Tích hợp dễ dàng vào hệ thống ERP, CRM.
Nhược điểm
– Tính phí dựa trên số lượng ảnh (ví dụ: $1.50/1,000 trang cho Google Vision).
– Cần cấu hình API key, bảo mật dữ liệu.
5. Hướng dẫn chi tiết sử dụng 3 công cụ phổ biến
5.1. Sử dụng Google Drive OCR
- Chuẩn bị file: Đảm bảo ảnh ở định dạng JPG/PNG, độ phân giải ≥ 300 DPI.
- Upload: Vào Google Drive → “New” → “File upload”.
- Mở bằng Google Docs: Click chuột phải → “Open with” → “Google Docs”. Google sẽ tự động thực hiện OCR.
- Kiểm tra kết quả: Văn bản sẽ xuất hiện dưới ảnh. Nếu là bảng, các cột thường được ngăn cách bằng tab.
- Chuyển sang Excel: “File” → “Download” → “Microsoft Excel (.xlsx)”.
- Post‑processing: Mở file Excel, dùng “Text to Columns” (Data → Text to Columns) để chia cột dựa trên tab hoặc dấu phẩy.
5.2. Sử dụng ABBYY FineReader
- Mở phần mềm, chọn “Open” → Chọn ảnh hoặc PDF.
- Chọn ngôn ngữ: Trong “Document Language”, tick “Vietnamese”.
- Chạy “Auto‑Layout”: Phần mềm sẽ tự động phát hiện bảng, tiêu đề, footnote.
- Chỉnh sửa: Nếu có lỗi, click vào ô để sửa. Bạn có thể kéo thả để hợp nhất hoặc tách ô.
- Export: “File” → “Save As” → “Microsoft Excel Workbook”.
- Kiểm tra: Đảm bảo các công thức, ngày tháng đúng định dạng.
5.3. Sử dụng Tesseract + Python (cho người dùng kỹ thuật)
import cv2
import pytesseract
import pandas as pd
from tabula import read_pdf # 1. Đọc ảnh và tiền xử lý
img = cv2.imread('table_image.jpg')
gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
_, thresh = cv2.threshold(gray, 150, 255, cv2.THRESH_BINARY_INV) # 2. OCR toàn bộ ảnh
custom_config = r'--oem 3 --psm 6 -l vie' # Vietnamese language pack
text = pytesseract.image_to_string(thresh, config=custom_config) # 3. Chuyển text thành DataFrame (giả sử dữ liệu cách nhau bằng tab)
rows = r.split('\t') for r in text.strip().split('\n') if r
df = pd.DataFrame(rows1:, columns=rows0) # 4. Lưu ra Excel
df.to_excel('output.xlsx', index=False)
Lưu ý:
– Cài đặt tesseract-ocr và ngôn ngữ vie.traineddata.
– Đối với bảng phức tạp, kết hợp pdfplumber hoặc camelot để trích xuất cấu trúc.
6. Những lỗi thường gặp và cách khắc phục
| Lỗi | Nguyên nhân | Cách khắc phục |
|---|---|---|
| Ký tự “0” thành “O” hoặc “1” thành “I” | Ảnh mờ, độ tương phản thấp | Tăng độ tương phản, sử dụng bộ lọc Sharpen; dùng công cụ tiền xử lý (Resize, Denoise). |
| Các cột bị dịch chuyển | Bảng có đường kẻ mỏng, không rõ ràng | Sử dụng công cụ “Detect Table” trong FineReader hoặc “Table Extraction” trong Adobe. |
| Dòng tiêu đề bị nhận dạng là dữ liệu | OCR không phân biệt tiêu đề | Đánh dấu tiêu đề bằng màu nền khác trước khi OCR, hoặc chỉnh sửa thủ công sau khi xuất. |
| Định dạng ngày tháng sai | Ngôn ngữ/định dạng không xác định | Sau khi xuất, dùng “Data → Text to Columns” → chọn Date format phù hợp (DD/MM/YYYY). |
| Số thập phân bị đổi dấu phẩy/dấu chấm | Ngôn ngữ cài đặt mặc định (US) | Thiết lập “Locale” trong công cụ OCR hoặc thay đổi định dạng số trong Excel (File → Options → Advanced → Use system separators). |
7. Lưu ý bảo mật và quyền riêng tư
- Dữ liệu nhạy cảm: Hóa đơn, hợp đồng, thông tin khách hàng – không nên tải lên các dịch vụ OCR trực tuyến nếu không có cam kết bảo mật.
- Sử dụng dịch vụ nội bộ: Đối với doanh nghiệp, cân nhắc triển khai Tesseract hoặc Azure Cognitive Services trong môi trường nội bộ (on‑premise) để kiểm soát dữ liệu.
- Xóa file tạm: Sau khi xử lý, xóa các bản sao ảnh gốc và file Excel tạm thời để tránh rò rỉ thông tin.
- Tuân thủ GDPR / PDPA: Nếu dữ liệu chứa thông tin cá nhân, cần có sự đồng ý của người dùng trước khi chuyển đổi và lưu trữ.
8. Tự động hoá quy trình chuyển đổi (Workflow)
8.1. Kịch bản cho doanh nghiệp nhỏ
- Bước 1: Nhân viên chụp ảnh báo cáo, lưu vào thư mục chung trên Google Drive.
- Bước 2: Sử dụng Google Apps Script để tự động chạy OCR khi file mới được upload, xuất ra Google Sheet.
- Bước 3: Sheet được chia sẻ với phòng kế toán, họ chỉ cần kiểm tra và duyệt.
function onDriveFileUpload(e) { var file = DriveApp.getFileById(e.id); var blob = file.getBlob(); var resource = { title: file.getName(), mimeType: blob.getContentType() }; var ocrFile = Drive.Files.insert(resource, blob, {ocr: true, ocrLanguage: 'vi'}); // Convert to Sheet var sheet = SpreadsheetApp.openById(ocrFile.id); // Thêm thông báo MailApp.sendEmail('accounting@example.com', 'New OCR file', 'File ' + file.getName() + ' đã chuyển sang Sheet.');
}
8.2. Kịch bản cho doanh nghiệp lớn
- Sử dụng Amazon Textract: Đặt bucket S3 chứa ảnh, kích hoạt S3 Event Notification để gọi Lambda function.
- Lambda xử lý kết quả Textract, lưu bảng vào Amazon RDS hoặc Redshift, đồng thời tạo file Excel trên Amazon S3.
- Các bộ phận liên quan có thể tải file từ S3 hoặc truy cập dữ liệu qua BI tool (Tableau, Power BI).
9. Các trường hợp đặc biệt
9.1. Bảng có hình ảnh hoặc biểu tượng
- OCR thường bỏ qua hình ảnh; nếu cần giữ lại, hãy tách phần hình ảnh ra và chèn lại vào Excel sau khi dữ liệu số đã sẵn sàng.
9.2. Bảng có nhiều mức độ hợp nhất ô (merged cells)
- FineReader và Adobe Acrobat có khả năng nhận dạng merged cells. Đối với Tesseract, cần post‑processing bằng script Python để xác định vị trí và hợp nhất ô trong pandas.
9.3. Đọc mã QR hoặc barcode trong cùng ảnh
- Sử dụng Zxing (Java) hoặc pyzbar (Python) để trích xuất mã, sau đó gắn vào cột tương ứng trong bảng Excel.
10. Tổng kết – Lựa chọn giải pháp phù hợp
| Yếu tố | Giải pháp đề xuất |
|---|---|
| Chi phí thấp, không chuyên sâu | Google Drive OCR, Microsoft OneNote |
| Chất lượng ảnh trung bình, cần layout chính xác | ABBYY FineReader, Adobe Acrobat Pro |
| Xử lý hàng loạt, tích hợp hệ thống | Tesseract + Python, Google Cloud Vision API, Amazon Textract |
| Bảo mật dữ liệu cao | Triển khai Tesseract nội bộ, Azure Computer Vision on‑premise |
| Đội ngũ kỹ thuật | Xây dựng pipeline tự động với Lambda + Textract hoặc Cloud Functions + Vision API |
Cuối cùng, chìa khóa thành công khi chuyển đổi ảnh sang Excel không chỉ nằm ở việc chọn công cụ mà còn ở quá trình chuẩn bị ảnh và kiểm tra lại dữ liệu. Đầu tư thời gian vào việc tiền xử lý (cân bằng độ sáng, loại bỏ nhiễu) sẽ mang lại lợi nhuận lớn hơn nhờ giảm công sức chỉnh sửa sau khi OCR. Khi đã nắm vững quy trình và các công cụ, bạn sẽ có thể biến bất kỳ bảng dữ liệu nào – dù là từ giấy tờ cũ, scan PDF, hay ảnh chụp điện thoại – thành một file Excel sạch sẽ, sẵn sàng cho phân tích và quyết định kinh doanh.
Hãy bắt đầu thử nghiệm ngay hôm nay, và đừng quên chia sẻ kinh nghiệm của bạn để cộng đồng cùng học hỏi!
Tiến sĩ Lê Thống Nhất sinh năm 1955 tại Nghệ An, là nhà giáo, nhà báo và doanh nhân trong lĩnh vực giáo dục. Ông từng giảng dạy Toán học tại Trường THPT Chuyên Phan Bội Châu và đảm nhiệm nhiều vai trò trong ngành giáo dục, từ viết sách, biên soạn tài liệu đến sáng lập các dự án hỗ trợ học tập trực tuyến.
Ông là người sáng lập BigSchool – nền tảng giáo dục trực tuyến kết nối giáo viên và học sinh cả nước. Ngoài ra, ông còn nổi tiếng với vai trò tác giả, diễn giả truyền cảm hứng và khách mời trên nhiều chương trình truyền hình, trong đó có “Ai là triệu phú” trên truyền hình VTV.
Trong suốt sự nghiệp, Tiến sĩ Lê Thống Nhất đã nhận nhiều giải thưởng giáo dục và được biết đến như một người luôn đổi mới, ứng dụng công nghệ vào dạy và học, góp phần lan tỏa tri thức và niềm say mê học tập cho thế hệ trẻ.